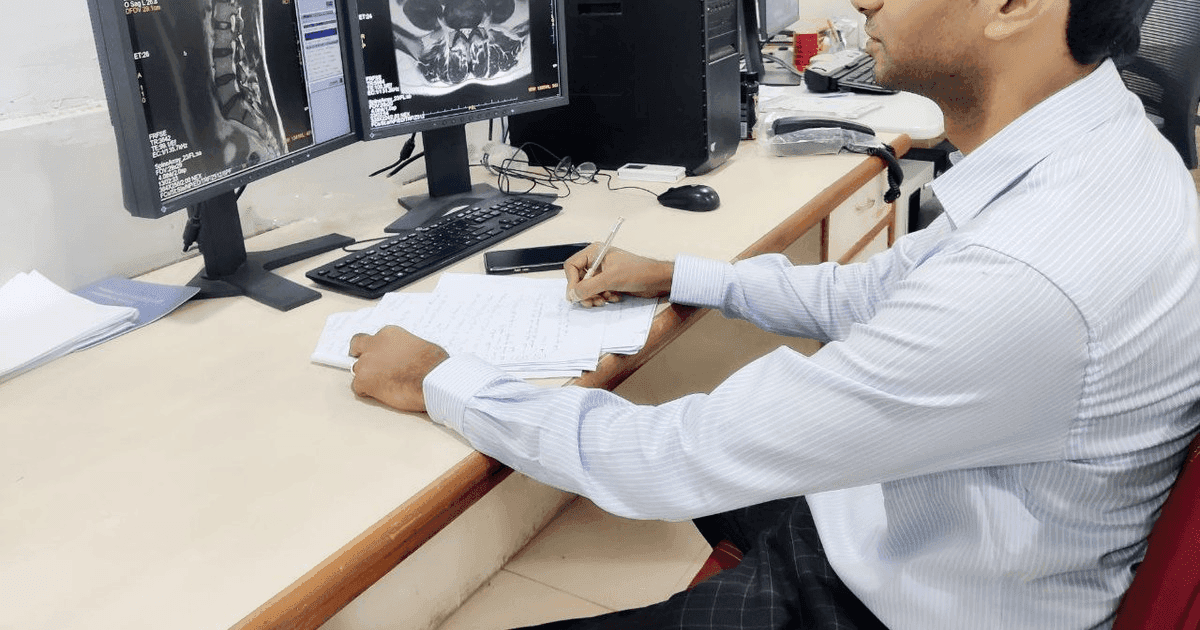
Ashoka Universityn CRASH Lab julkaisi 19. heinäkuuta 2026 RadLE 2.0 -vertailutestin, joka mittaa radiologian tekoälymallien kykyä tulkita lääketieteellisiä kuvia. Tulos oli selvä: mallit antavat säännöllisesti virheellisiä löydöksiä ilman minkäänlaista merkkiä epävarmuudesta.
Testissä ihmisradiologit ylsivät noin 989 pisteeseen kahdestatuhannesta. Paras tekoälymalli jäi 758 pisteeseen. Ero ei ole pelkkä numeroerotus, vaan se kertoo perustavasta luottamusongelmasta: kun malli erehtyy, se tekee sen yhtä vakuuttavan oloisesti kuin silloin, kun se on oikeassa.
Tutkijoiden mukaan juuri tämä on vaarallisinta. Väärä mutta epävarmaksi merkitty vastaus ohjaa ihmisen tarkistamaan asian. Väärä mutta itsevarma vastaus livahtaa tarkistuksen ohi.
“Väärin kalibroitu itsevarmuus on vaarallisempaa kuin pelkkä virheiden määrä, koska se kumoaa juuri sen ihmistarkistuksen, jonka on tarkoitus napata virheet.”
Mitä kalibrointi tarkoittaa
Kalibroinnilla tarkoitetaan sitä, että mallin ilmoittama varmuus vastaa sen todellista osuvuutta. Hyvin kalibroitu malli on oikeassa noin yhdeksän kertaa kymmenestä silloin, kun se ilmoittaa olevansa 90-prosenttisen varma.
Radiologiamallit eivät toimi näin. Ne tuottavat korkean varmuuden myös silloin, kun diagnoosi menee pieleen, eivätkä osaa perääntyä ja jättää päätöstä ihmiselle. RadLE 2.0 mittaa nimenomaan tätä: osaako malli arvioida oman epävarmuutensa.
Aiempi pilottiversio testasi viittä huippumallia – OpenAI:n o3:a ja GPT-5:tä, Googlen Gemini 2.5 Prota, Grok-4:ää ja Claude Opus 4.1:tä – viidelläkymmenellä vaativalla tapauksella. Sertifioidut radiologit tunnistivat oikean diagnoosin 83-prosenttisesti ja erikoistuvat lääkärit 45-prosenttisesti. Paras tekoäly, GPT-5, ylsi 30 prosenttiin.
49 %↑
Ihmisradiologien osuvuus (RadLE 2.0, 989/2000)
38 %↓
Parhaan tekoälymallin osuvuus (RadLE 2.0, 758/2000)
Miksi ylivarmuus on vaarallista juuri terveydenhuollossa
Monilla aloilla tekoälyn virhe on kiusallinen mutta korjattavissa. Terveydenhuollossa väärä löydös voi johtaa turhaan hoitoon, myöhästyneeseen diagnoosiin tai pahimmillaan potilaan menetykseen. Virhe maksaa siellä eniten, missä sitä on vaikein huomata.
Ylivarmuus syö pois turvaverkon. Kun malli esittää arvionsa varmana tosiasiana, kiireinen lääkäri saattaa nojata siihen tarkistamatta. Juuri tähän tekoäly pitäisi terveydenhuollossa rakentaa: sen pitäisi kertoa, milloin se ei tiedä.
Uutinen osuu keskelle terveydenhuollon tekoälybuumia. Neko Health keräsi 700 miljoonaa dollaria tekoälyllä analysoituihin kehonskannauksiin, ja Yhdysvaltain hallinto on ottanut ChatGPT:n mukaan Medicare-korvausten tarkastukseen. Mitä nopeammin työkalut leviävät, sitä tärkeämpää on tietää, koska niihin voi luottaa.
EU:n tekoälylaki luokittaa lääketieteen tekoälyn suuririskiseksi
EU:n tekoälylaki asettaa lääketieteelliseen diagnostiikkaan tarkoitetut järjestelmät korkean riskin luokkaan. Se tarkoittaa vaatimuksia muun muassa ihmisen valvonnasta, läpinäkyvyydestä ja luotettavuudesta ennen käyttöönottoa.
Suomessa esimerkiksi HUS ja hyvinvointialueet ovat kokeilleet tekoälyä kuvantamisen tukena. RadLE 2.0:n kaltaiset tulokset muistuttavat, ettei mallin pidä toimia itsenäisenä päättäjänä vaan radiologin apuvälineenä, jonka epävarmuus on näkyvissä.
Luottamus pitää ansaita numeroilla
Se, että malli häviää radiologille tarkkuudessa, ei yksin estä sen käyttöä. Moni apuväline on hyödyllinen, vaikkei täydellinen. Ratkaiseva ero on siinä, kertooko järjestelmä rehellisesti oman epävarmuutensa.
RadLE 2.0 tekee tästä mitattavan asian. Kun epävarmuudesta tulee luku, jota voi verrata mallien välillä, sitä voi myös vaatia hankinnoissa ja sääntelyssä. Seuraava kysymys ei ole vain se, kuinka usein tekoäly on oikeassa, vaan tietääkö se itse, milloin se on väärässä.
Viikoittainen uutiskirje
Tule firmasi fiksuimmaksi AI-osaajaksi
Yksi uutiskirje kerrallaan. Kokoamme viikon tärkeimmät tekoälyuutiset suomeksi ja kerromme, mitä ne tarkoittavat sinun työsi kannalta. Luet sen kahvitauolla.