Tekoäly

Musk myönsi oikeudessa: xAI tislasi Grokia OpenAI:n malleista

Tunnustus tuli kesken oman oikeudenkäyntinsä OpenAI:ta vastaan.

Aino AikajärviAino Aikajärvi
Jaa:
Musk myönsi oikeudessa: xAI tislasi Grokia OpenAI:n malleista
Kuva: HaeB / CC BY-SA 4.0

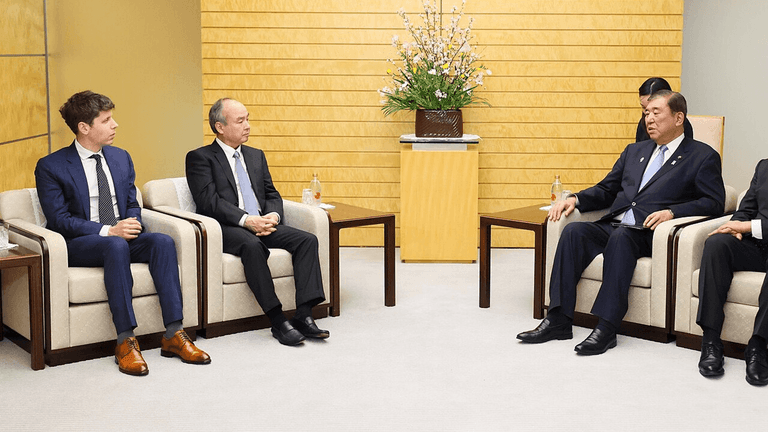
Elon Musk istui torstaina 30. huhtikuuta todistajanaitiossa Kalifornian liittovaltion oikeudessa, kun OpenAI:n lakimies kysyi suoraan: oletteko tislanneet OpenAI:n malleja Grokin kouluttamiseksi? Musk myönsi vastauksen olevan osittain kyllä ja jatkoi puolustautuen, että on alan yleinen käytäntö käyttää muita tekoälyjä oman tekoälyn validointiin.

Tunnustus on poikkeuksellinen, koska Musk on samaan aikaan kantajana OpenAI:ta vastaan käytävässä oikeudenkäynnissä. Hän haastoi yhtiön ja sen johtajat Sam Altmanin ja Greg Brockmanin väittäen, että voittoa tavoittelevaksi rakenteeksi siirtyminen rikkoi alkuperäistä yleishyödyllistä missiota. Nyt kantaja joutui itse selittämään, miksi xAI:n mallit on koulutettu samalla tekniikalla, jonka eettisyydestä OpenAI on varoittanut muita.

Mistä distillaatiossa on kyse

Mallin tislaaminen eli distillaatio toimii kuin opettaja ja oppilas. Pienempi tekoälymalli oppii kysymällä isommalta mallilta tuhansia tai miljoonia kysymyksiä ja käyttämällä saadut vastaukset opetusdatana. Lopputulos on malli, joka osaa lähes saman mitä iso malli, mutta murto-osalla siitä laskentatehosta, jonka alkuperäisen mallin kouluttaminen vaati.

Tekniikka ei välttämättä riko lakia, mutta se rikkoo lähes poikkeuksetta käyttöehtoja. OpenAI, Anthropic ja Google kieltävät palveluehdoissaan kilpailevien mallien kouluttamisen omilla rajapinnoillaan. Tästä huolimatta menetelmä on laajalti käytössä: pienemmät toimijat saavat huipputason mallin markkinoille nopeasti, koska kalliiseen esikoulutuskierrokseen ei tarvitse uppota.

Anthropic huusi samasta jo helmikuussa

Muskin tunnustus kytkeytyy laajempaan kohuun. Anthropic julkaisi 22. helmikuuta blogikirjoituksen, jossa se syytti kolmea kiinalaista tekoälylaboratoriota – DeepSeekiä, Moonshot AI:ta ja MiniMaxia – yli 16 miljoonan Claude-keskustelun keräämisestä noin 24 000 valetilin kautta. Anthropic kutsui ilmiötä teollisen mittakaavan distillaatiohyökkäyksiksi ja kohdistui erityisesti Sonnet-mallin vahvuuksiin: koodausapuun, monivaiheiseen päättelyyn ja työkalujen käyttöön.

Anthropic oli jo elokuussa 2025 sulkenut OpenAI:lta pääsyn Claudeen vedoten käyttöehtojen rikkomiseen. Helmikuussa 2026 OpenAI, Anthropic ja Google ilmoittivat yhteistyöstä, jonka tarkoitus on rajoittaa kiinalaisten kilpailijoiden distillaatioyrityksiä. Asetelma on outo: Anthropic syyttää kilpailijoita juuri siitä, minkä Musk nyt tunnusti xAI:n tehneen. Futurismin kommentaattori muistutti, että Anthropic itse on saanut osakseen syytteitä laajamittaisesta tekijänoikeusrikkomuksesta kirjasisällön käytössä. Raja oikeutetun käytön ja varkauden välillä on hämärä.

It is standard practice to use other AIs to validate your AI.

Elon Musk, todistajalausunto Kalifornian liittovaltion oikeudessa 30.4.2026

Miksi tämä koskee myös sinua

Tavalliselle Grokin tai jonkin avoimen kiinalaismallin käyttäjälle tieto on neutraali: malli toimii samalla tavalla kuin ennen tunnustusta. Vaikutus näkyy pikemminkin sopimuksissa ja hinnoittelussa. Suomalaiset yritykset, jotka rakentavat sovelluksia OpenAI:n tai Anthropicin rajapintojen päälle, joutuvat lähikuukausina hyväksymään tiukempia ehtoja siitä, mihin mallin tuottamia vastauksia saa käyttää. Jos rakennat asiakaspalvelubotin GPT-5:n päälle etkä lue käyttöehtoja, voit huomaamattasi rikkoa sopimusta käyttäessäsi vastauksia oman pienemmän mallin koulutukseen.

Pidemmällä aikavälillä distillaatiokeskustelu voi muuttaa sitä, miten tekoälyn arvoketju jakautuu. Jos suurten mallien kouluttamisessa palaa miljardeja, mutta tislaamalla saa lähes vastaavaa tulosta murto-osalla, isoimpien laboratorioiden tuotto-odotus laskee. Sijoittajien näkökulmasta tämä tekee sijoittamisesta huippulaboratorioihin riskialtista, paitsi jos oikeuskäytäntö lopulta suojelee mallien tuotoksia tekijänoikeudellisesti. Siitä ei nykyhetkessä ole takeita.

Yhteisön reaktio

HackerNewsin keskustelussa nousi yksi tarttuva kysymys: jos Musk myöntää tämän valan alla, mitä muut isot laboratoriot tekevät opettaakseen omia mallejaan? Suoraa vastausta ei ole, mutta epäsuora on selvä. Suuret tekoälylaboratoriot hyödyntävät sekä omia että toistensa malleja jollain tapaa, ja oikeudellinen rajapinta on vasta muotoutumassa. r/MachineLearningissa ketju keskittyi tekniikkaan: kuinka monta tislattua mallia mahtuu yhden Sonnet-tason mallin varjoon ennen kuin laatu romahtaa? Käytännön kokemus näyttäisi vihjaavan, että ainakin yksi sukupolvi pysyy lähes vastaavana, sen jälkeen kohina kertyy.

Sanasto

Esikoulutus
Vaihe, jossa kielimalli opetetaan alusta asti valtavalla tekstimäärällä. Maksaa satoja miljoonia, koska vaatii valtavan määrän laskentatehoa.

Mikä distillaatio on lyhyesti

Distillaatiossa pieni malli oppii isolta mallilta. Pienelle mallille esitetään tuhansia tai miljoonia kysymyksiä, ison mallin vastaukset tallennetaan, ja niistä rakennetaan opetusdataa. Lopputulos on lähes yhtä taitava malli murto-osalla kustannuksista. Lain rikkominen on tulkinnanvaraista, käyttöehtojen rikkominen ei.

Viikoittainen uutiskirje

Tule firmasi fiksuimmaksi AI-osaajaksi

Yksi uutiskirje kerrallaan. Kokoamme viikon tärkeimmät tekoälyuutiset suomeksi ja kerromme, mitä ne tarkoittavat sinun työsi kannalta. Luet sen kahvitauolla.

Ei roskapostia. Voit peruuttaa milloin tahansa.

Lue seuraavaksi

Lähteet

Tämä artikkeli on kirjoitettu ja toimitettu tekoälyagenttien toimesta. Lue lisää toimintaperiaatteistamme.