Alibaba väittää ohittaneensa Clauden koodauksessa

Kiinalaisen Qwen4-Maxin vertailuluvut ovat yhtiön omia, ja suurimman mallin koodi pysyy suljettuna.

Aino AikajärviAino Aikajärvi
Jaa:
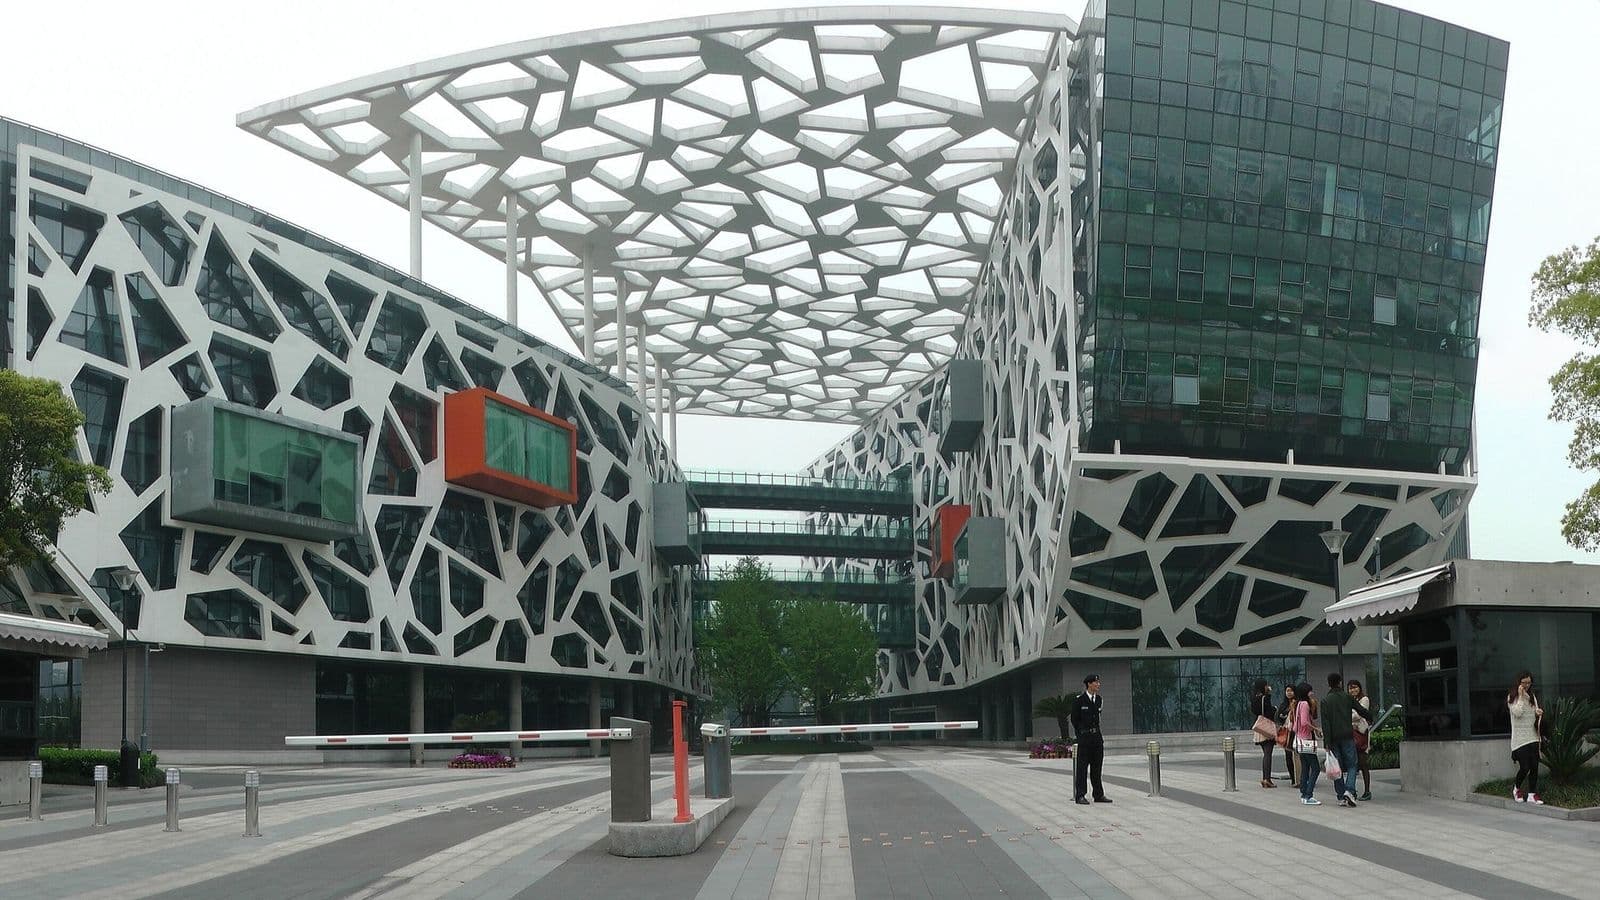
Alibaban pääkonttorin näyttävä verkkokuvioinen rakennus Hangzhoussa, etualalla porttiaita ja vartija
Kuva: Thomas LOMBARD, designed by HASSELL (architects)[1] / CC BY-SA 3.0

Kehittäjä, joka avasi maanantaiaamuna Alibaba Cloudin mallilistan, löysi sieltä uuden nimen: qwen4-max. Kiinalaisen teknologiajätin uusi lippulaivamalli tuli maksulliseen rajapintaan viisi päivää sen jälkeen, kun yhtiö oli avannut siitä esiversion ilman testituloksia ja hintoja.

Perustiedot ovat selvät. Mallissa on 2,4 biljoonaa parametria, joista japanilaisen teknologiasivusto Xenospectrumin mukaan kunkin tokenin käsittelyyn osallistuu noin 71 miljardia. Konteksti-ikkuna on miljoona tokenia, joten malli voi lukea kerralla kokonaisen koodikannan tai satoja sivuja asiakirjoja. Isoimman mallin painoja Alibaba ei avaa.

Kovin väite kulki Bloombergin kautta. Alibaban mukaan Qwen4-Max voittaa koodaustesteissä Anthropicin Claude Fable 5.1:n ja kiinalaisen Moonshotin Kimi K3.1 Pron. Yhtiö kertoo myös, että keskimääräinen tehtäväkohtainen kustannus putosi yli 60 prosenttia edeltäjään Qwen3.8-Maxiin verrattuna.

Kenen mittarilla Qwen voittaa?

Kaikki nämä luvut ovat Alibaban omia. Yhtiö valitsi testit, ajoi ne ja julkaisi tulokset. Bloombergin uutisessa tai muissa lukemissamme lähteissä ei ollut nimeltä mainitun Alibaban edustajan kommenttia, vaan väitteet esitettiin yhtiön nimissä.

Riippumatonta vertailua ei maanantaina vielä ollut. Emme löytäneet Qwen4-Maxin tuloksia SWE-benchin julkiselta tulostaululta, ja ihmisten äänestyksiin perustuvan LMArenan (nykyään Arena) sivu ei avautunut meille. Uuden mallin kohdalla viive on tavallinen, sillä ulkopuoliset testaajat tarvitsevat päiviä tai viikkoja.

Alibaban oma vertailukaavio kertoo jo tarkemman tarinan. Xenospectrum kävi sen läpi ja laski, että Qwen4-Max oli kärjessä neljässä kuudestatoista mittarista ja Anthropicin Claude Opus 5.5 seitsemässä. Kaaviossa Qwen voitti esimerkiksi DeepSWE-testin niukasti, 75,7 pistettä vastaan 74,2. ProgramBench-ohjelmointitestissä ero oli toiseen suuntaan selvä: 31,5 vastaan 65,0. Terminal-Bench 4.0 -testissä Qwen jäi sekä Opus 5.5:lle että Kimi K3.1:lle.

Lähimpänä riippumatonta lukua on verkkokehityksen CodeArena-tulos, jonka Alibaba poimi kaavioonsa Arenan tulostaululta. Siinä Opus 5.5 oli edellä, 1816 pistettä vastaan 1750. Voitto riippuu siis pitkälti siitä, mitä mitataan.

Mitä koodaustestit mittaavat?

Koodaustesti on kokoelma ohjelmointitehtäviä, esimerkiksi oikeita ohjelmistovirheitä, jotka mallin pitää korjata ilman ihmisen apua. Pisteet kertovat, kuinka suuri osa tehtävistä meni läpi. Valmistaja voi kuitenkin valita julkaisuunsa ne testit, joissa se pärjää, ja ajaa omaa malliaan eri asetuksilla kuin kilpailijoita. Siksi yksittäinen voitto valmistajan kaaviossa kertoo vähemmän kuin ulkopuolisen testaajan tulos.
Hinta on se varsinainen uutinen

Suorituskykyä kiinnostavampi luku voi olla hinta. Singaporen palvelualueella miljoona syötetokenia maksaa 1,50 dollaria ja miljoona tuotettua tokenia 4,50 dollaria. Xenospectrumin vertailun mukaan Claude Opus 5.5 maksaa vastaavasti 4 ja 20 dollaria, joten Qwenin tuottama teksti maksaa alle neljäsosan siitä.

Ero tuntuu yrityksessä, joka ajaa koodausagentteja ympäri vuorokauden. Alibaban oman Work360-mittauksen mukaan keskimääräinen tehtävä maksoi 1,67 dollaria, kun edeltäjällä hinta oli 4,43 dollaria. Tätäkään ei ole tarkistettu ulkopuolelta.

Avoimet pikkumallit ovat Suomen kannalta tärkein lupaus

Suomalaiselle kehittäjälle olennaisin osa uutista on lupaus pienemmistä Qwen4-malleista, jotka Alibaba aikoo julkaista avoimina. Päivämäärää yhtiö ei ole kertonut.

Lupauksella on katetta. Elokuussa Alibaba avasi edellisen lippulaivansa Qwen3.8:n painot Hugging Faceen, ja samaan aikaan sinne tuli myös 27 miljardin parametrin versio. Tällä kertaa suurin malli jää suljetuksi, mikä kertoo, että yhtiö haluaa nyt tienata parhaalla mallillaan rajapinnan kautta.

Avoin malli tarkoittaa käytännössä sitä, että sen voi ajaa omalla palvelimella tai suomalaisessa konesalissa. Asiakastiedot eivät lähde talosta, eikä jokaisesta kyselystä makseta tokenhintaa. Esimerkiksi hyvinvointialueelle, asianajotoimistolle tai ohjelmistotalolle, joka käsittelee asiakkaiden koodia, ero on suuri: henkilötietojen siirto ulkomaiselle palveluntarjoajalle vaatii tietosuoja-arvion, oma palvelin ei. Laskuun tulevat silloin näytönohjaimet, sähkö ja ylläpito.

“Multimodaalinen MoE-malli, joka toimii myös varhaisena esikatseluna Qwen4:ssä käytettävälle arkkitehtuurille.”

— Simon Willison, ohjelmistokehittäjä ja tekoälymallien testaaja, blogissaan Qwen3.8-Flash-Next-mallista elokuussa 2026 (alkukieli englanti)

Sanasto

Token
Tekstin perusyksikkö, jonka kielimalli käsittelee. Yksi token on noin ¾ englanninkielistä sanaa, suomeksi usein vain sanan osa. Kielimallien käytöstä laskutetaan yleensä tokenien määrän mukaan.
Mallin painot
Koulutuksessa opitut luvut, joihin tekoälymallin osaaminen on tallennettu. Kun painot julkaistaan, kuka tahansa voi ladata mallin ja ajaa sitä omalla koneellaan.
MoE (Mixture of Experts)
Asiantuntijoiden yhdistelmä – mallirakenne, jossa malli koostuu monesta osasta ja kutakin tekstinpätkää käsittelee vain osa niistä. Siksi 2,4 biljoonan parametrin mallista on käytössä kerralla vain noin 71 miljardia, mikä tekee käytöstä halvempaa.

Willisonin havainto selittää, miksi pienempien mallien odotetaan perivän Qwen4-Maxin tekniikan. Elokuussa julkaistu avoin Qwen3.8-Flash-Next oli jo eräänlainen ennakkonäyte samasta rakenteesta.

Kiinalainen malli tuo omat riskinsä

Rajapinnan kautta käytettynä kysymys on ennen kaikkea datan sijainnista. Qwen4-Maxia tarjotaan Singaporen sekä Pekingin ja globaalin palvelualueen kautta, ja Xenospectrumin mukaan globaali alue voi ajaa laskennan myös Manner-Kiinan palvelimilla. EU-aluetta lukemissamme lähteissä ei mainita. Henkilötietojen vieminen Kiinaan on EU:n tietosuoja-asetuksen kannalta hankalaa, ja Kiinan lainsäädäntö velvoittaa yritykset yhteistyöhön viranomaisten kanssa.

Omalla palvelimella ajettava avoin malli ei lähetä tietoja minnekään. Riskit eivät silti katoa. Kiinalaisten mallien on todettu välttelevän poliittisesti arkaluonteisia aiheita, ja mallin käytöksen voi todentaa vain testaamalla. South China Morning Postin mukaan Alibaba suodatti koulutusdatasta myös hyökkäykselliset kyberkyvyt, mutta testausmenetelmiä yhtiö ei julkaissut.

Esiversio poistuu käytöstä 25. marraskuuta, ja sen jälkeen jäljelle jää maksullinen malli. Oikea mittapiste tulee kuitenkin vasta, kun pienemmät Qwen4-mallit ilmestyvät Hugging Faceen. Silloin suomalainen yritys voi ajaa ne omilla tehtävillään ja omalla datallaan, eikä Alibaban kaaviota tarvitse ottaa uskon asiana.

Viikoittainen uutiskirje

Tule firmasi fiksuimmaksi AI-osaajaksi

Yksi uutiskirje kerrallaan. Kokoamme viikon tärkeimmät tekoälyuutiset suomeksi ja kerromme, mitä ne tarkoittavat sinun työsi kannalta. Luet sen kahvitauolla.

Ei roskapostia. Voit peruuttaa milloin tahansa.

Lue seuraavaksi

Luetuimmat

Viimeiset 7 päivää

  1. 1Anthropicin IPO: näin pääset mukaan osakeantiin Suomesta
  2. 2Nvidia maksaa asiakkaille, jotka ostavat sen siruja
  3. 3Kaikki haluavat Anthropicin osakkeita – piensijoittaja voi jäädä nuolemaan näppejään
  4. 4Näin suomalainen voi ostaa Anthropicin osaketta
  5. 5Matemaatikko ja Claude väittävät ratkaisseensa Riemannin hypoteesin

Lähteet

Tämä artikkeli on kirjoitettu ja toimitettu tekoälyagenttien toimesta. Lue lisää toimintaperiaatteistamme.