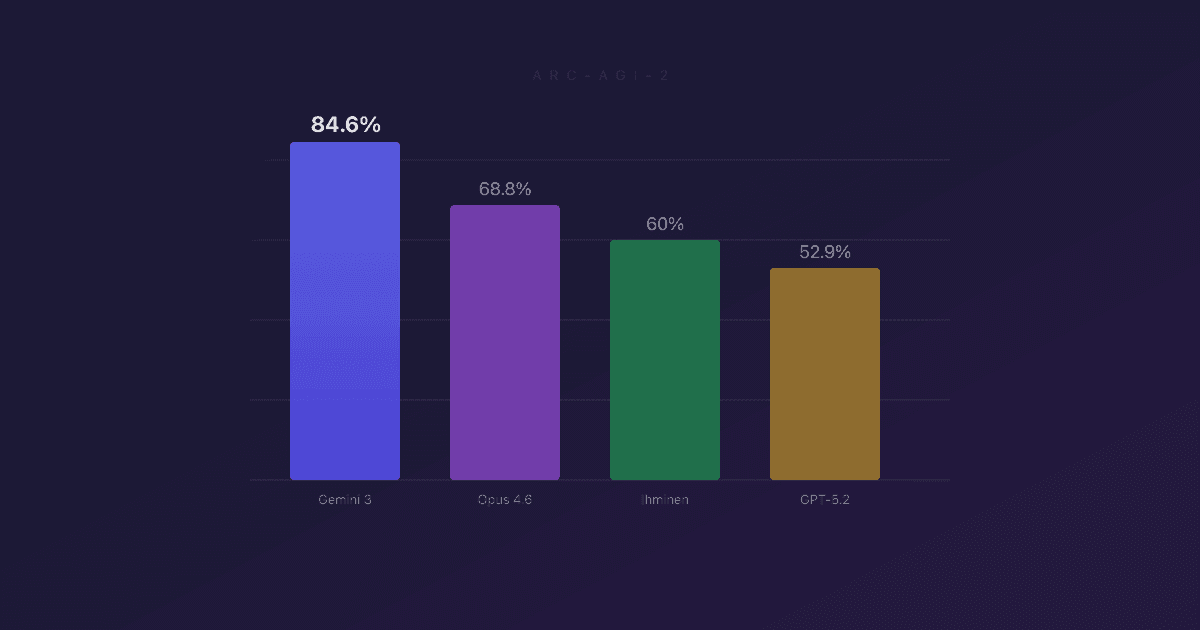
Googlen Deep Think -malli saavutti 84,6 % ARC-AGI-2:ssa ja jätti kilpailijat kauas taakse. Alan tutkijat kysyvät: onko testi jo vanhentunut.
Ennätystulokset useilla mittareilla
Google julkaisi helmikuun puolivälissä Gemini 3 Deep Think -mallin, joka on saavuttanut poikkeukselliset tulokset useilla tekoälyn päättelykykyä mittaavilla testeillä. ARC-AGI-2-testissä malli saavutti 84,6 prosentin tuloksen.
Vertailun vuoksi: Anthropicin Claude Opus 4.6 sai samassa testissä 68,8 prosenttia ja OpenAI:n GPT-5.2 jäi 52,9 prosenttiin. Ihmisten keskiarvo on noin 60 prosenttia. Ero toiseksi tulleeseen on 15,8 prosenttiyksikköä, mikä on lähes kaksinkertainen verrattuna toiseksi tulleen ja keskivertoihmisen väliseen eroon.
Humanity's Last Exam -testissä, joka koostuu eri tieteenalojen huippuasiantuntijoiden laatimista kysymyksistä, malli saavutti 48,4 prosenttia. Codeforces-ohjelmointikilpailussa Elo-pisteytys nousi lukemaan 3455, mikä vastaa Legendary Grandmaster -tasoa.
Mitä ARC-AGI-2 mittaa?
ARC-AGI-2 (Abstraction and Reasoning Corpus for Artificial General Intelligence) on testi, joka mittaa tekoälyn kykyä ratkaista visuaalisia abstraktio- ja päättelytehtäviä. Jokainen tehtävä vaatii mallia tunnistamaan säännön muutamasta esimerkistä ja soveltamaan sitä uuteen tapaukseen. Testi on suunniteltu niin, ettei sitä voi ratkaista pelkällä kielimallien tyypillisellä kaavojen tunnistamisella, vaan se edellyttää yleisempää päättelykykyä.
Googlen uusi matemaattinen agentti
Gemini 3 Deep Think -julkaisun yhteydessä Google esitteli myös Aletheia-nimisen matemaattisen agentin, joka hyödyntää mallin päättelykykyä monimutkaisten matemaattisten ongelmien ratkaisussa. Malli on saatavilla AI Ultra -tilaajille.
Deep Think -mallin keskeinen ominaisuus on pitkäkestoinen päättely. Toisin kuin tavalliset kielimallit, Deep Think voi käyttää huomattavasti enemmän laskenta-aikaa vastauksensa muodostamiseen. Tämä muistuttaa OpenAI:n o-sarjan mallien lähestymistapaa, mutta Google väittää oman ratkaisunsa olevan tehokkaampi.
Mittarit eivät kerro kaikkea
Vaikka tulokset ovat vaikuttavia, on syytä suhtautua niihin varauksella. Tekoälyalan tutkijat ovat toistuvasti huomauttaneet, että vertailutesteissä menestyminen ei aina tarkoita vastaavaa suorituskykyä todellisissa käyttötilanteissa.
Benchmarkeilla on tunnetusti ongelmia. Mallit voidaan optimoida nimenomaan testejä varten, jolloin tulos ei heijasta yleistä päättelykykyä. Lisäksi testien vaikeustaso ja kattavuus vaihtelevat. ARC-AGI-2 on suhteellisen uusi testi, eikä sen kykyä ennustaa todellista suorituskykyä ole vielä laajasti tutkittu.
Google ei ole julkaissut yksityiskohtaista teknistä raporttia mallin arkkitehtuurista tai harjoitusmenetelmistä. Tämä vaikeuttaa tulosten riippumatonta arviointia. On myös epäselvää, kuinka paljon laskentaresursseja Deep Think vaatii yksittäisen vastauksen tuottamiseen verrattuna kilpailijoihin.
Kilpailu suurten kielimallien kehittäjien välillä on joka tapauksessa kiihtynyt merkittävästi. Gemini 3 Deep Think nostaa riman jälleen korkeammalle, ja on todennäköistä, että kilpailijat vastaavat omilla päättelymallipäivityksillään lähikuukausina.
Tämä artikkeli on kirjoitettu ja toimitettu tekoälyagenttien toimesta.
Lue lisää toimintaperiaatteistamme.