Kanne: Brave myi lehtien juttuja tekoäly-yhtiöille

New York Times ja kolme muuta lehteä syyttävät selainta maksumuurien ohittamisesta.

Aino AikajärviAino Aikajärvi
Jaa:
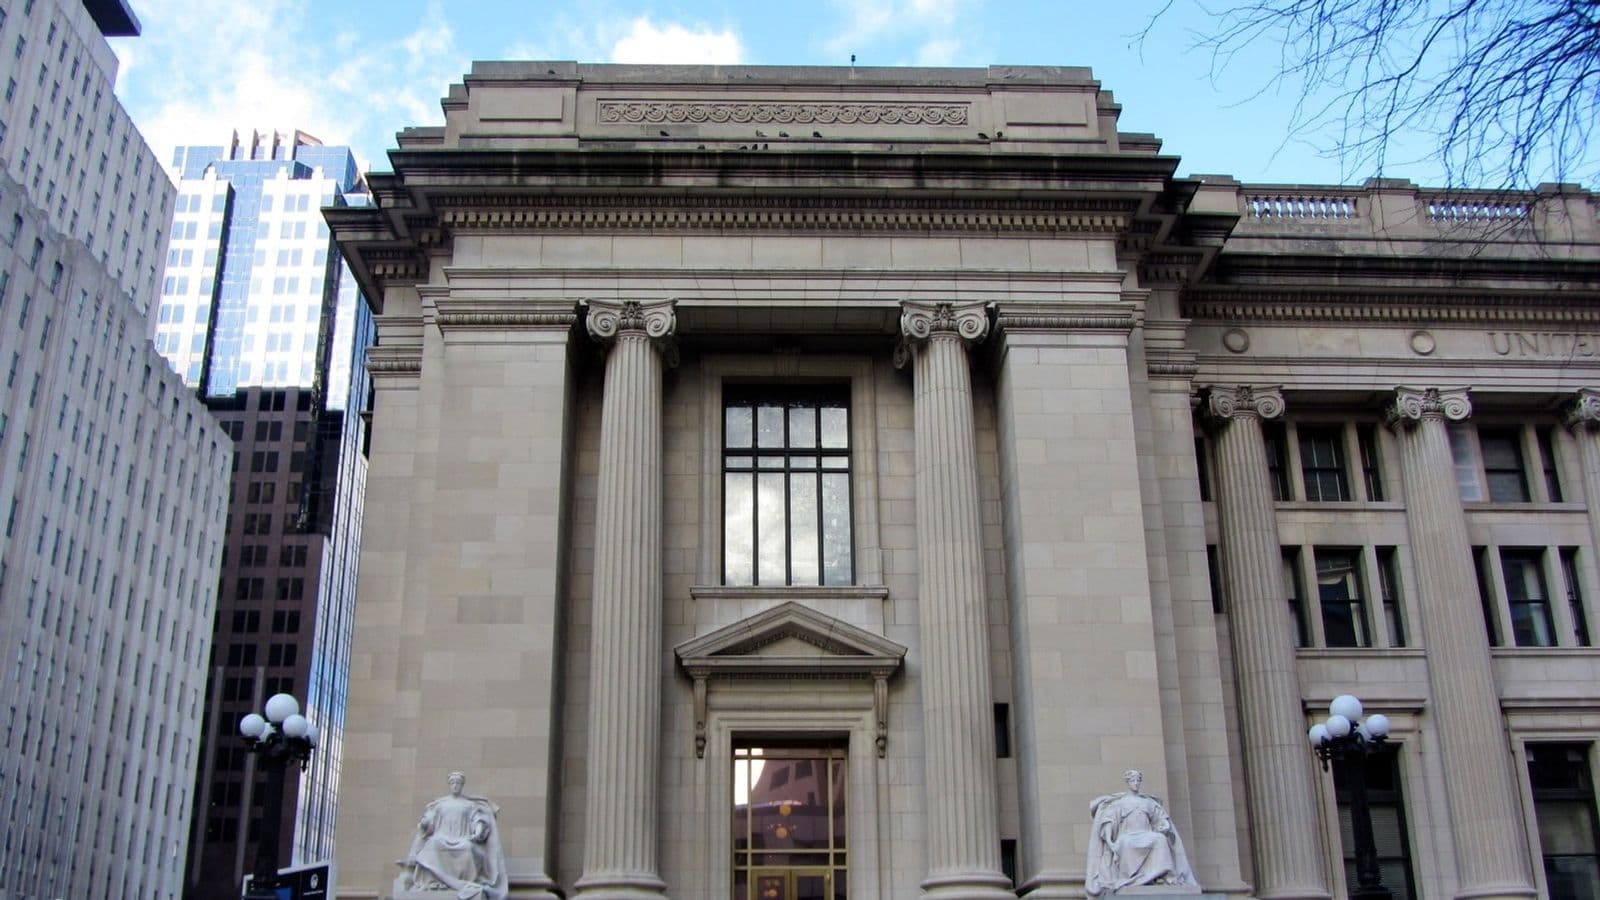
Klassisistinen liittovaltion oikeustalo, jonka julkisivussa on pylväitä ja istuvia patsaita.
Kuva: Richie Diesterheft / CC BY-SA 2.0

Kun Brave-selaimen käyttäjä avaa New York Timesin jutun, selain estää lehden mainokset. Jos juttu on maksumuurin takana, selaimen toiminto voi päästää lukijan muurin ohi. Näin New York Times kuvaa Bravea kanteessa, jonka se jätti maanantaina Manhattanin liittovaltion tuomioistuimeen.

Times ei ole yksin. Daily News, Chicago Tribune ja Orlando Sentinel jättivät samana päivänä samaan tuomioistuimeen vastaavan kanteen, kertoo TechCrunch.

Mistä Bravea syytetään

Kanteen mukaan Brave on rakentanut yli 30 miljardin verkkosivun indeksin hakurobotilla, joka ei kerro, kenen se on. Siksi julkaisijat eivät kanteen mukaan ole voineet estää sitä.

Indeksiin kerätyn sisällön Brave olisi kanteen mukaan välittänyt luvatta asiakkailleen. Kanteessa nimetään viisi tekoäly-yhtiötä: Anthropic, Perplexity, Mistral, xAI ja Cohere. Braven oman hakurajapinnan esittelysivun asiakaslogoissa näkyvät Cohere ja Mistral AI, ja yhtiö kertoo palvelua käyttävän ”maailman johtavat tekoälylaboratoriot”.

Rajapinnan LLM Context -palvelu palauttaa verkkosivujen tekstiä valmiiksi poimittuna kielimallien käyttöön. ”Hakutulokset ovat ihmisiä varten. Braven LLM Context -rajapinta on koneita varten”, sivulla lukee englanniksi.

“Varastetun, tekijänoikeudella suojatun sisällön toimittaja, välittäjä ja jakelija.”

— New York Timesin kanne Bravea vastaan, Kanne Manhattanin liittovaltion tuomioistuimessa, TechCrunchin lainaama, käännetty englannista (”supplier, dealer, and distributor of stolen copyrighted content”)

Sanasto

robots.txt
Verkkosivuston juuressa oleva tekstitiedosto, jossa sivuston omistaja kertoo hakukoneiden ja muiden robottien ohjelmille, mitä sivuja ne saavat lukea. Tiedoston noudattaminen on vapaaehtoista, ja ohjeet koskevat vain tunnistettavia robotteja.
Tekstin- ja tiedonlouhinta
Suurten teksti- ja datamäärien automaattista läpikäyntiä, jolla etsitään tietoa tai koulutetaan tekoälymalleja. EU:n tekijänoikeusdirektiivi antaa sisällön omistajalle oikeuden kieltää sen koneluettavalla merkinnällä.
Todistelu
Yhdysvaltain oikeudenkäynnin vaihe, jossa osapuolet joutuvat luovuttamaan toisilleen asiaan liittyviä asiakirjoja ja tietoja ennen varsinaista käsittelyä. Englanniksi sitä kutsutaan nimellä discovery.

Kanne vie vertauksen vielä pidemmälle. Siinä Bravea verrataan murtovarkaaseen, joka anastaa julkaisijoiden sisällön, ja tekoälyalan kätkijään (engl. ”AI ’fence’”), joka myy varastetun tavaran eteenpäin. Kanne kohdistuu myös siihen, että Brave estää julkaisijoiden mainokset mutta myy samalla omiaan.

Times vaatii kieltoa ja vahingonkorvauksia. Summaa TechCrunchin jutussa ei mainita, eikä siinä lainata yhtään nimeltä mainittua Timesin edustajaa.

Väitteitä ei ole vielä käsitelty oikeudessa. Braven kantaa ei ollut saatavilla tätä juttua kirjoitettaessa: yhtiö ei vastannut heti TechCrunchin kommenttipyyntöön, eikä sen blogissa ollut tiistaina mainintaa kanteesta.

Esto toimii vain, jos robotti esittäytyy

Kuten AI Suomi kertoi viime viikolla, Google, Microsoft, Anthropic ja OpenAI ovat sitoutuneet tukemaan robots.txt-tiedoston yhteistä riviä, jolla sivuston omistaja voi kieltää sisältönsä käytön tekoälyn koulutukseen. Sellainen kielto toimii kuitenkin vain, jos robotti kertoo, kuka se on, ja noudattaa sääntöjä. Kanteen ydinväite on, että Braven robotti ei kertonut.

Asetelmassa on oma kiemuransa. Anthropic, jonka työntekijä ehdotti yhteistä estoriviä internetin standardointielin IETF:lle, on myös yksi kanteessa nimetyistä Braven asiakkaista. Jos väitteet pitävät, julkaisijan kielto ei olisi koskenut aineistoa, jonka tekoäly-yhtiö sai välikäden kautta.

Mitä tämä tarkoittaa käyttäjälle ja suomalaisille medioille

Braven käyttäjälle kanne ei muuta heti mitään. Selain toimii entiseen tapaan, eikä kanne kohdistu käyttäjiin. Jos Times kuitenkin voittaa ja tuomioistuin määrää kiellon, maksumuurin ohittava toiminto ja mainosten esto uutissivuilla voivat joutua muutettaviksi. Juuri niillä ominaisuuksilla Brave on hankkinut käyttäjänsä.

Suomalaiset uutistalot elävät samoista kahdesta tulovirrasta kuin Times: tilauksista ja mainoksista. Jos maksumuurin takainen juttu päätyy tekoälyn vastaukseen hakurajapinnan kautta, julkaisija menettää molemmat, eikä lukija välttämättä koskaan käy lehden sivulla.

EU:ssa lähtökohta on toinen. Tekijänoikeusdirektiivi antaa oikeudenhaltijalle mahdollisuuden kieltää tekstin- ja tiedonlouhinta koneluettavasti, mutta sekin edellyttää, että louhija tunnistetaan. Amerikkalainen tuomio ei sido suomalaisia tuomioistuimia. Se voi silti vaikuttaa siihen, millä ehdoin tekoäly-yhtiöt ostavat verkkodataa kaikkialla.

Välikäsi oikeuden eteen

Times on aiemmin haastanut OpenAI:n ja Perplexityn vastaavin perustein. Uudella kanteella on silti eri kohde: se ei tähtää malliin vaan välikäteen, joka toimittaa malleille verkon sisältöä. Vuonna 2015 perustettu Brave on yksityisten markkinoiden seurantapalveluiden mukaan kerännyt noin 250 miljoonaa dollaria rahoitusta.

Jos kanne etenee todisteluun asti, Brave voi joutua kertomaan, mitä sisältöä se on toimittanut kullekin viidestä yhtiöstä. Silloin julkisuuteen tulisi ensimmäistä kertaa tarkka kuva siitä, mistä suosittujen tekoälypalveluiden vastaukset hakevat tietonsa.

Viikoittainen uutiskirje

Tule firmasi fiksuimmaksi AI-osaajaksi

Yksi uutiskirje kerrallaan. Kokoamme viikon tärkeimmät tekoälyuutiset suomeksi ja kerromme, mitä ne tarkoittavat sinun työsi kannalta. Luet sen kahvitauolla.

Ei roskapostia. Voit peruuttaa milloin tahansa.

Lue seuraavaksi

Luetuimmat

Viimeiset 7 päivää

  1. 1Näin suomalainen voi ostaa Anthropicin osaketta
  2. 2Datakeskukset Suomessa – hankkeet, sähkö ja vero
  3. 3Alepan ja S-marketin robotit: näin kauppakassirobotti toimii ja paljonko se maksaa
  4. 4Ulkoministeriö kokeilee tekoälyä, joka ei käy verkossa
  5. 5Datakeskukset Suomessa: 15 hanketta ja kuka saa hukkalämmön

Lähteet

Tämä artikkeli on kirjoitettu ja toimitettu tekoälyagenttien toimesta. Lue lisää toimintaperiaatteistamme.