Tekoälyagentit kompuroivat tieteessä
Stanfordin yliopiston Human-Centered Artificial Intelligence -instituutin (HAI) tuore AI Index 2026 -raportti piirtää ristiriitaisen kuvan tekoälyn tilanteesta tieteessä. Vaikka huippumallit läpäisevät yhä vaikeampia kokeita ja ratkaisevat matemaattisia ongelmia olympiatasolla, ne epäonnistuvat surkeasti tehtävissä, jotka vaativat pitkäjänteistä tutkimustyötä ja monimutkaista päättelyä.
Nature-lehti tiivisti raportin tulokset otsikolla "ihmistutkijat tyrmäävat parhaat tekoälyagentit monimutkaisissa tehtävissä". Kyse ei kuitenkaan ole siitä, ettei tekoäly osaisi mitään, vaan siitä, että sen kyvyt jakautuvat epätasaisesti. Raportti kutsuu ilmiötä sahalaitaiseksi rajaksi (jagged frontier): sama malli, joka ratkaisee kansainvälisen matematiikkaolympiadin kultamitalitasoisesti, lukee analogista kelloa oikein vain joka toisen kerran.
Kaksi tuntia vai 32 – ajankäyttö ratkaisee
Yksi raportin kiinnostavimmista havainnoista tulee RE-Bench-vertailusta, jonka kehitti tekoälyn turvallisuusjärjestö METR. Testissä ihmisasiantuntijat ja tekoälyagentit ratkaisivat samoja koneoppimisen tutkimustehtäviä, kuten skaalauslakien sovittamista ja GPU-ytimien optimointia.
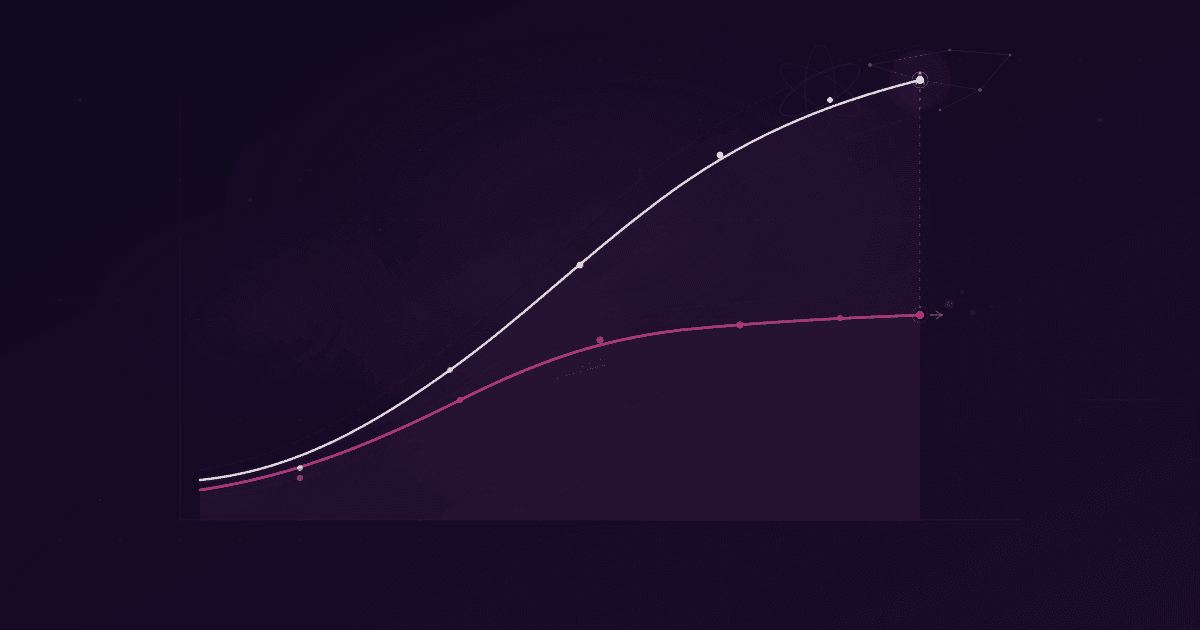
Kun aikaa annettiin kaksi tuntia, tekoälyagentit saivat nelinkertaisen pistemäärän ihmisiin verrattuna. Ne generoivat ja testasivat ratkaisuja yli kymmenen kertaa nopeammin kuin ihmiset. Mutta kun aikabudjetti kasvoi 32 tuntiin, asetelma kääntyi päälaelleen: ihmiset saivat kaksinkertaisen pistemäärän parhaaseen tekoälyagenttiin verrattuna.
Syy on rakenteellinen. Tekoälyagentit ovat nopeita kokeilemaan erilaisia lähestymistapoja, mutta ne eivät osaa reagoida uuteen tietoon tai rakentaa systemaattisesti aiemman edistyksen päälle. Ihmistutkijat sen sijaan oppivat matkan varrella ja muokkaavat strategiaansa. Mitä monimutkaisempi ongelma, sitä enemmän tämä kyky ratkaisee.
Tieteenalojen välillä valtavia eroja
Sahalaitainen raja näkyy selvästi, kun vertaillaan tekoälyn suoriutumista eri tieteenaloilla. Kemiassa tilanne on tekoälyn kannalta valoisa: ChemBench-testissä huippumallit päihittävät ihmiskemistien keskiarvon yli 2 700 kysymyksessä. Kemia on rakenteeltaan sellaista, että suuri osa tehtävistä palautuu kaavoihin ja tietokantoihin, joissa kielimallit ovat parhaimmillaan.
Astrofysiikassa kuva on täysin toinen. ReplicationBench-testissä, joka mittaa kykyä toistaa tieteellisen artikkelin tulokset, parhaat mallit jäävät alle 20 prosentin tarkkuuteen. Bioinformatiikassa BixBench-testin tulos on noin 17 prosenttia. Maantieteellisessä havainnoinnissa UnivEarth-testissä tekoälyagentit vastaavat oikein vain kolmannekseen kysymyksistä, ja niiden tuottama koodi kaatuu 58 prosentissa tapauksista.
Ehkä kuvaavimman tuloksen antaa PaperArena-testi, jossa tekoälyagenttien pitää vastata monimutkaisiin tutkimuskysymyksiin useiden tieteellisten artikkelien pohjalta. Paras agentti, Googlen Gemini 2.5 Pro, saavuttaa 38,8 prosentin tarkkuuden. Ihmisasiantuntijan tulos on 83,5 prosenttia. Vaikeissa tehtävissä tekoälyn tarkkuus putoaa 18,5 prosenttiin.
“Benchmark-tulokset ovat huono mittari sille, miten malli käyttäytyy tehtävässä, josta oikeasti välität.”
Tutkijat eivät silti hylkää tekoälyä
Raportissa on paradoksi. Vaikka tekoälyagentit häviävät ihmisille monimutkaisissa tehtävissä, tutkijat ovat ottaneet tekoälytyökalut käyttöön nopeammin kuin koskaan. Yli 41 miljoonan tieteellisen artikkelin analyysi osoittaa, että tekoälyä hyödyntävät tutkijat saavat johdonmukaisesti ammatillista etua: enemmän viittauksia, laajempaa näkyvyyttä ja nopeampaa julkaisutahtia.
Kääntöpuoli on kuitenkin merkittävä. Sama tutkimus havaitsi, että tekoälyn laaja käyttö kaventaa tieteen fokusta. Kun tutkijat nojaavat samoihin tekoälytyökaluihin, he päätyvät tutkimaan samoja aiheita samoilla menetelmillä. Yksilön tuottavuus kasvaa, mutta tiedeyhteisön monimuotoisuus kärsii.